关联规则
关联规则概述
关联规则依据大量数据中存在的特定关系,通过对数据的分析,发现之间的联系。已经在电商、零售、大气物理、生物医学等多个方面有了广泛的应用。
关联规则的概念和定义
关联规则概念最早是由Agrawal等人在1993年首先提出的,最初的动机是针对购物篮分析问题提出的,其目的是为了发现交易数据库中不同商品之间的联系规则。Agrawal等人于1993年提出了关联规则挖掘算法AIS,但是性能较差。1994年,他们建立了项目集格空间理论,并提出了著名的Apriori算法,至今Apriori仍然作为关联规则挖掘的经典算法被广泛讨论。
-
项(Item)、项集(Itemset)、k-项集与事务 项:是指数据库中不可分割的最小单位。 项集:是指多个项的集合,其中,空集是指不包含任何项的项集。 k-项集:是指由k个项构成的项集组合。 事务:是指用户定义的一个数据库操作序列,这些操作序列是一个不可分割的工作单位。
-
支持度(Support) 支持度:是指项集在所有训练元组中同时出现的次数,因此,支持度可以表述为 \begin{equation} \text { Support }(X->Y)=|X \cup Y| /|N| \end{equation} 其中,X,Y ⊆ N,X∩Y=Ф,|X U Y|表示集合X与Y在一个事务中同时出现的次数,|N|表示数据记录的总个数。
-
置信度(Confidence) 置信度可以表述为: \begin{equation} \text { Confidence }(X->Y)=|X \cup Y| /|X|=\text { Support }(X->Y) / \text { Support }(X) \end{equation} 其中,X,YN,X∩Y=Ф,|X U Y|表示集合X与Y在一个事务中同时出现的次数,|X|表示X出现的总次数。也可以看成是在X发生的条件下Y发生的概率,即 P( Y | X )。
-
频繁项集(Frequent Itemset) 频繁项集:是指在所有训练元组中同时出现的次数,超过人工定义的阈值的项集。在关联规则的挖掘过程中,一般只保留候选项集中满足支持度条件的项集,不满足条件的舍弃。 频繁项集是指那些经常出现在一起的物品,例如上图的{啤酒、尿布、牛奶},从上面的数据集中也可以找到尿布->啤酒的关联规则,这意味着有人买了尿布,那很有可能他也会购买啤酒。那怎么才算是经常呢,就要用到支持度来衡量。如果大于某个支持度,咱们就说它算是频繁项集。
-
极大频繁项集(Frequent Large Itemset) 极大频繁项集:不存在包含当前频繁项集的频繁超集,则当前频繁项集就是极大频繁项集。 超集:如果一个集合S2中的每一个元素都在集合S1中,且集合S1中可能包含S2中没有的元素,则集合S1就是S2的一个超集,反过来,S2是S1的子集。 S1是S2的超集,若S1中一定有S2中没有的元素,则S1是S2的真超集,反过来S2是S1的真子集。
-
关联(Association):两个或多个变量的取值之间存在某种规律性。
-
关联规则(Association rule):指从事务数据库、关系数据库和其他信息存储中的大量数据的项集之间发现有趣的、频繁出现的模式、关联和相关性。
-
关联分析(Association analysis):用于发现隐藏在大型数据集中的令人感兴趣的联系。所发现的联系可以用关联规则或者频繁项集的形式表示。关联规则挖掘就是从大量的数据中挖掘出描述数据项之间相互联系的有价值的有关知识。
在给定的事务数据库中,关联规则挖掘问题就是通过用户或者专家指定的最小支持度(min support) 和最小置信度(min confidence)来寻找合适关联规则的过程。
一般地,关联规则挖掘问题可以划分成两个子问题: 1)发现频繁项目集 通过用户给定的min support ,寻找所有频繁项目集,即满足Support不小于min support的项目集。事实上,这些频繁项目集可能具有包含关系。一般地,我们只关心那些不被其它频繁项目集所包含的所谓频繁大项集的集合。这些频繁大项集是形成关联规则基础。 2)生成关联规则 通过用户给定的min confidence ,在每个最大频繁项目集中,寻找Confidence不小于min confidence的关联规则。这两个子问题主要在之后Apriori算法中进行介绍。
关联规则的分类
-
基于规则中处理的变量的类别,关联规则可以分为布尔型和数值型。
-
基于规则中数据的抽象层次,可以分为单层关联规则和多层关联规则。
-
基于规则中涉及到的数据的维数,关联规则可以分为单维的和多维的。
-
布尔型和数值型 布尔型 一般处理的数据是“属于”或“不属于”,“是”或“不是”的关系。 处理的值都是离散的、种类化的。 买啤酒 → 买尿布 数值型 数据项是数量型 月收入1000元 → 每月上网吧花800元
-
单层关联规则和多层关联规则 单层关联规则中,所有的变量都没有考虑到显示的数据是具有多个不同的层次。 {IBM 台式机} → {Sony 打印机} 多层关联规则中,对数据的多层性进行了充分的考虑。 {台式机} → {Sony 打印机}
-
单维和多维 单维关联规则:啤酒 → 尿布,只涉及到用户的购买的物品,表示在一个属性内的规则 多维关联规则:性别=”女” → 职业=”秘书”,涉及到两个属性维度性别和职业
关联规则的挖掘过程
关联规则的挖掘定义: 给定一个交易数据集T,找出其中所有支持度support ≥ min support, 置信度confidence ≥ min confidence 的关联规则
频繁项集产生
频繁项集就是支持度大于或等于最小支持度的那些项集。如何快速高效地发现所有频繁项集,是关联规则的核心问题,也是衡量关联规则挖掘算法效率的重要标准。
- 格结构 格结构常常被用来枚举所有可能的项集,右图显示 I={A,B,C,D,E}的项集格。一般来说,一个包含d项的数据集可能包含2^𝑘次方的频繁项集(包括一个空集)。
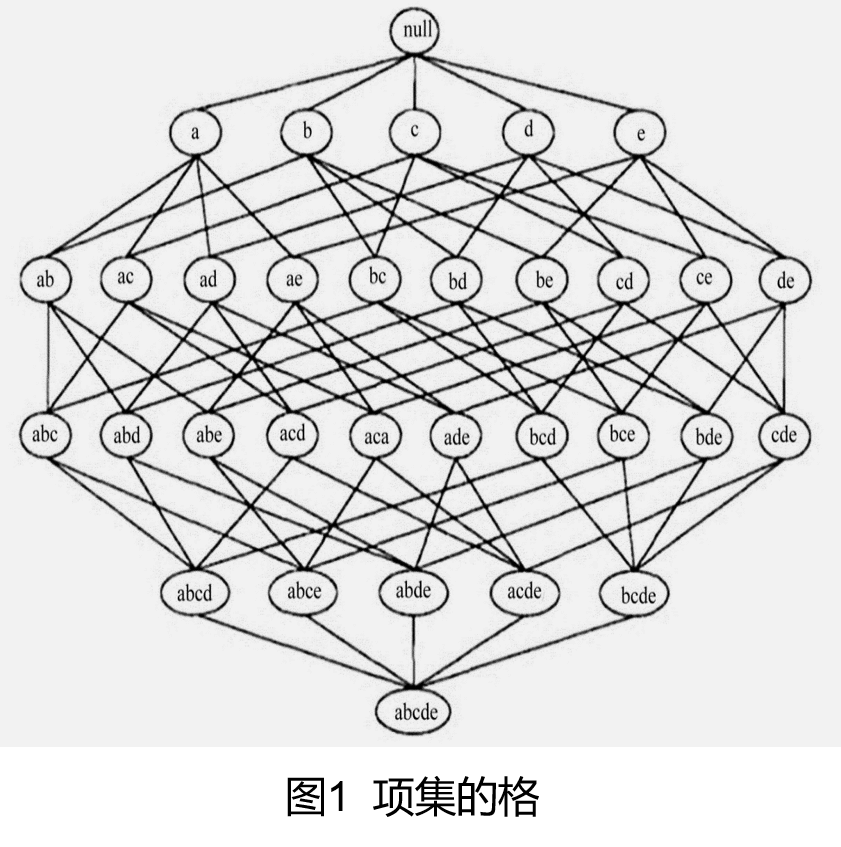
发现频繁项集的一种原始方法是确定格结构中每个候选项集的支持度计数。比如下面的图中,由于项集(候选项){bread,milk}出现在事务1, 4和5中,其支持度计数将增加3次。
这种方法的开销可能非常大,因为它需要进行O(NMw)次比较,其中N是事务数,M=2^{k}-1 是候选项集数(去掉了空集),而w是事务的最大宽度(一个事务有几个项,事务的宽度就是多少)。
有几种方法可以降低产生频繁项集的计算复杂度 减少选项集M的个数 减少对比的次数(NM)
如果一个项集是频繁的,则它的所有子集一定也是频繁的 → 如果项集的子集不频繁,则该项集必定不频繁
假定{CDE}是频繁项集,那任何包含{CDE}的事务一定包含它的子集{C,D},{C,E},{D,E},{C},{D},{E},这样,如果{CDE}是频繁的,则他的所有子集一定也是频繁的。
如果项集{A,B}是非频繁的,如右图所示,则它的超集,{A,B,C,D},{A,B,C,E},{A,B,D,E},{A,B,C},{A,B,D},{A,B,E}也一定是非频繁的。则整个包含{A,B}的超集可以被立即减枝。
这种支持度度量剪指数搜索空间的策略称为基于支持度的剪枝。 这种剪枝策略依赖于支持度度量的一个关键性质,就是一个项集的支持度决不会超过它的子集的支持度。
关联规则挖掘所花费的时间主要是在生成频繁项集上,因为找出的频繁项集往往不会很多,利用频繁项集生成规则也就不会花太多的时间,而生成频繁项集需要测试很多的备选项集,如果不加优化,所需的时间是
强关联规则
生成关联规则是指通过用户给定的最小置信度,在每个最大频繁项集中,寻找置信度不小于min confidence和支持度不小于min support的关联规则。
关联规则评价标准
在某些特定情况下,仅凭支持度和置信度来衡量一条规则,是完全不够的,对于数据的筛选力度也不足。因此,需要介绍更多的判断强关联规则的评价标准,来满足实际需求。
支持度和置信度并不能过成功滤掉那些我们不感兴趣的规则,因此我们需要一些新的评价标准,下面介绍六中评价标准:相关性系数,卡方指数,全置信度、最大置信度、Kulc、cosine距离。
-
相关性系数lift (提升度) 引入正相关和负相关的机制,对于不是正相关的商品规则,可以用相关性系数lift过滤掉。 对于规则A->B或者B->A,\begin{equation} \operatorname{lift}(A, B)=P(A \cap B) /\left(P(A)^{\star} P(B)\right) \end{equation},如果lift(A,B)>1表示A、B呈正相关,lift(A,B)<1表示A、B呈负相关,lift(A,B)=1表示A、B不相关(独立)。 实际运用中,正相关和负相关都是我们需要关注的,而独立往往是我们不需要的,两个商品都没有相互影响也就是不是强规则,lift(A,B)等于1的情形也很少,一般只要接近于1,便认为是独立了。
-
卡方指数 卡方分布是数理统计中的一个重要分布,利用卡方系数我们可以确定两个变量是否相关。卡方系数的定义: \begin{equation} \chi^{2}=\sum \frac{(\text { observed }-\text { expcted })^{2}}{\text { expcted }} \end{equation} 其中observed表示实际值,expected表示期望值
-
全置信度all_confidence 全置信度的定义如下: \begin{equation} \begin{array}{l} \text { all confidence }(A, B) \ =P(A \cap B) / \max {P(A), P(B)} \ =\min {P(B \mid A), P(A \mid B)} \ =\min {\text { confiden } \operatorname{ce}(A->B), \text { Confidence }(B->A)} \end{array} \end{equation}
-
最大置信度max_confidence 最大置信度则与全置信度相反,求的不是最小的支持度而是最大的支持度, \begin{equation} \max \text { confidence }(\mathrm{A}, \mathrm{B})=\max {\mathrm{confidence}(\mathrm{A}->\mathrm{B}), \text { confiden } \mathrm{ce}(\mathrm{B}->\mathrm{A})} \end{equation} 不过最大置信度不太实用。
-
KULC系数 Kulc系数本质上是对两个置信度做一个平均处理,公式为: \begin{equation} \operatorname{kulc}(\mathrm{A}, \mathrm{B})=(\text { confidence }(\mathrm{A}->\mathrm{B})+\operatorname{confiden} \mathrm{ce}(\mathrm{B}->\mathrm{A})) / 2 \end{equation}
-
cosine距离 \begin{equation} \begin{array}{l} \operatorname{cosine}(A, B) \ =P(A \cap B) / \operatorname{sqrt}\left(P(A)^{\star} P(B)\right) \ =\operatorname{sqrt}\left(P(A \mid B)^{\star} P(B \mid A)\right) \ =\operatorname{sqrt}\left(\operatorname{confidence}(A->B)^{*} \operatorname{confidence}(B->A)\right) \end{array} \end{equation}